Facebook
 LinkedIn
 LINE
 Reddit
 WhatsApp
 Kakao

CPU 在 Agentic AI 應用的重要性
過往,在資料中心內,CPU 扮演伺服器的「大腦」,負責所有複雜的邏輯判斷、序列處理,在經典的機器學習 (Linear Regression、Decision Trees 等) 也表現出色。
然而,進入 AI 爆發時代,由於 AI 模型需要同時執行大量的矩陣運算 (Matrix Multiplication),並由具有高度並行性 (Embarrassing Parallelism) 的 GPU 同時進行大量簡單數學運算,CPU 僅負責壓縮、分配記憶體中的數據給 GPU 工作,使得 GPU 的重要性逐漸超越 CPU。現今 AI 資料中心中,CPU:GPU 比例約為 1:4 至 1:8。
表 1. CPU vs. GPU 比較
| 晶片類型 | CPU | GPU |
|---|---|---|
| 原理 | 較複雜的邏輯判斷、序列處理 | 較簡單的並行運算 |
| 核心數 | 少 (數十~數百個) | 多 (數千~數萬個) |
| 核心記憶體 | DRAM | HBM |
| AI 應用 | 資料預處理、任務分配 | AI 模型運算 |
| 代表供應商 | Intel、AMD、Ampere (Softbank) | Nvidia、AMD、Intel |
來源:TrendForce
從 Agentic AI 驅動與新 CPU:GPU 比例,解析 CPU 再傳緊缺背後的結構性轉變
NVIDIA Vera CPU 機架與 Arm AGI CPU 揭示架構轉型訊號,解析代理 AI 浪潮驅動的 CPU 短缺及 GPU/CPU 比例結構性變化。
深入解析然而,隨著 AI Agent 的應用落地,CPU 的角色迎來重大轉機。Agentic AI 與靜態的 LLM 不同,旨在透過 Agents 和動態環境互動,使 AI 模型能夠主動規劃、呼叫工具,達到獨立做出決策、代替用戶執行行動。其中,協調 (Orchestration) 就是 CPU 的重要工作。在第一次呼叫 AI agent 後,AI Agent 會產生執行計劃與許多 Sub-agents,而 CPU 必須負責協調 Sub-agents 間的任務編排、工具呼叫、資料傳遞,並整合 Sub-agents 的成果、評估原始請求是否已滿足。因此,在 Agentic Inference 過程中會需要更多的 CPU。
圖 1. CPU 在 Agentic Inference 過程中的角色
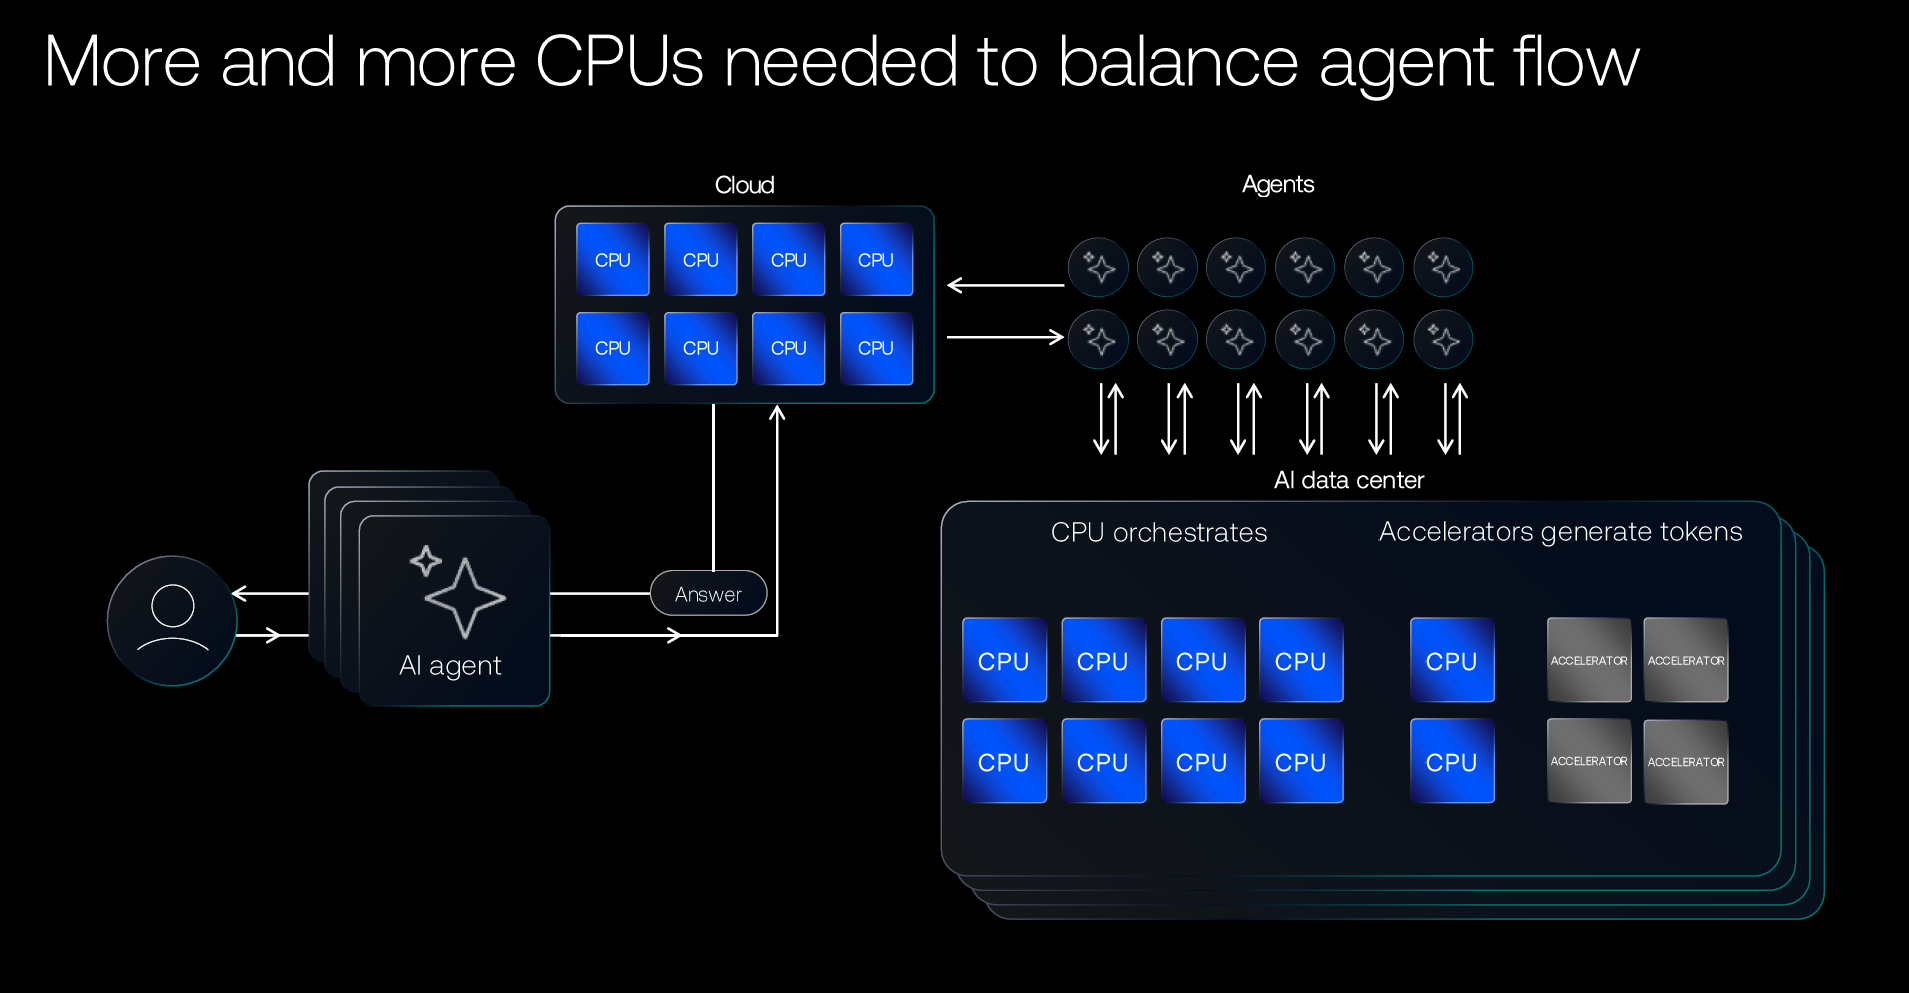
來源:Arm
此外,Agent AI 與強化學習 (Reinforcement Learning, RL) 結合形成的 Agentic RL 使得 CPU 更為重要。而對 AI Agent 的每一個行動進行評估 (Evaluation) 的過程進一步提升了 CPU 的需求。
2025 年 11 月,論文〈A CPU-Centric Perspective on Agentic AI〉也提出 CPU 在 Python 解譯、網路爬蟲、詞彙式摘要、資料庫搜尋等工具處理中仍扮演關鍵角色,而 Agentic AI 仍具備這些大量使用 CPU 的場景。因此,AI Agent 在 CPU 方面可能面臨三大瓶頸:
- 延遲 (Latency):CPU 處理時間可能佔總延遲的 90.6%。
- 吞吐量 (Throughput):吞吐量瓶頸可能是 CPU 因素 (核心數、一致性、同步性) 或 GPU 因素 (核心記憶體容量、頻寬)。
- 能耗 (Energy):在大批量處理時,CPU 動態功耗可能佔總功耗的 44%。
因此,過往的 CPU:GPU 比例需要改變。根據 Arm 推估,傳統 AI 資料中心每 GW 約需要 3,000 萬顆 CPU 核心。進入 AI Agent 時代後,需求將提升至 1.2 億顆 CPU 核心、約 4 倍需求量。未來的 CPU:GPU 比例可能增至 1:1 至 1:2,使市場對 CPU 需求大幅升高。
圖 2. Agentic AI 應用的 CPU:GPU 比例變化
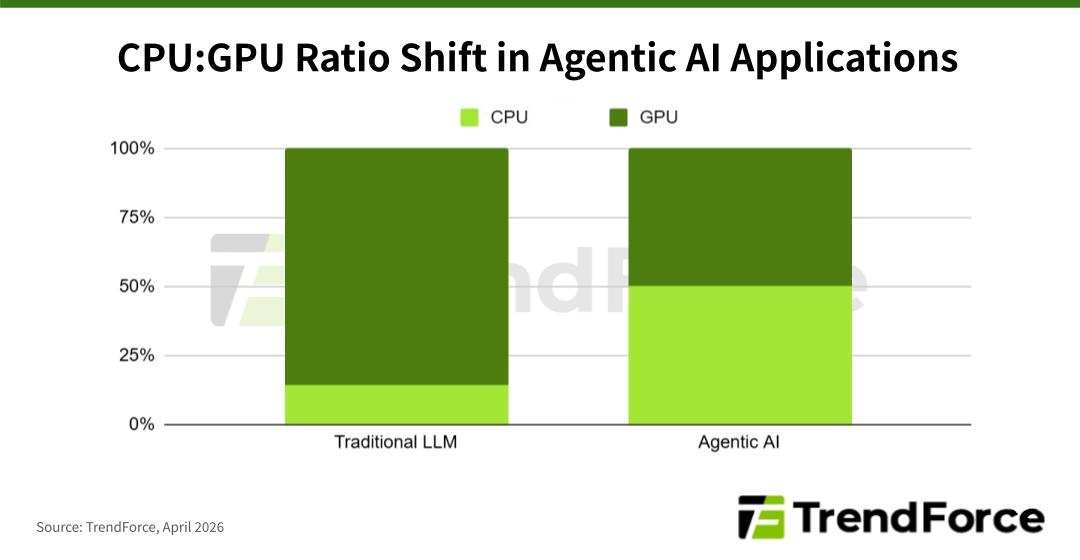
來源:TrendForce
有關推理經濟如何重塑 AI 晶片架構的深入分析,請參閱 推理經濟崛起:AI 晶片規則正在改寫。
由於 AI 資料中心對 AI 與一般伺服器的 CPU 需求激增,也使得 Intel、AMD 在 1Q26 季底開始對部分 CPU 產品線漲價。
2026 年 CPU 市場競爭態勢
在日益擴大的 CPU 市場中,除了傳統伺服器 CPU 供應商 Intel、AMD,許多非傳統伺服器 CPU 供應商也紛紛推出自研的 CPU 以切入新的業務、共同解決 AI 運算瓶頸,如 GPU 供應商 Nvidia、IP 供應商 Arm,以及 AWS、Google、Microsoft 等各大 CSP。
(一) 傳統 x86 架構 CPU 供應商 (Intel、AMD)
Intel 的 Xeon 系列伺服器 CPU 長年維持超過 95% 的市場份額,直到 2021 年因 Intel 7 製程良率問題,導致 Xeon Sapphire Rapids 延後近兩年量產,AMD 得以藉 EPYC Milan(採用台積電 N7 製程、Zen3 架構)實現市占突破。
2026 年,Intel 分別在高效能的 E-Core 和高性能的 P-Core 產品線推出 Xeon 6+ (Clearwater Forest) 與 Xeon 7 (Diamond Rapids)。
Xeon 6+ (Clearwater Forest) 採用全新的 Darkmont 架構,核心數/執行緒數高達 288/288,TDP 約 450W,並首次應用 Foveros Direct 的 Hybrid Bonding 技術。Xeon 7 (Diamond Rapids) 則採用全新的 Panther Cove-X 架構,核心數/執行緒達 256/256,TDP 約 650W。
AMD 則維持由台積電代工,2026 年推出的 EPYC Venice 為全新的 Zen6 架構,採用台積電 N2 製程與 CoWoS-L、SoIC 先進封裝,核心數/執行緒數可以高達 256/512。預計在採用台積電代工的策略下,AMD 2026 年將持續搶佔 Intel 市佔率。
(二) 新興 Arm 架構 CPU 供應商 (Nvidia、Arm、Ampere、AWS、Google、Microsoft)
2026 年 3 月,Nvidia 在 GTC 大會宣佈將單獨販售 Vera CPU,以應對客戶對 CPU:GPU 更靈活配置的需求,第一批合作廠商包括阿里巴巴、字節跳動、Cloudflare、CoreWeave、Crusoe、Lambda、Nebius、Nscale、Oracle、Together.AI、Vultr 等 CSP。
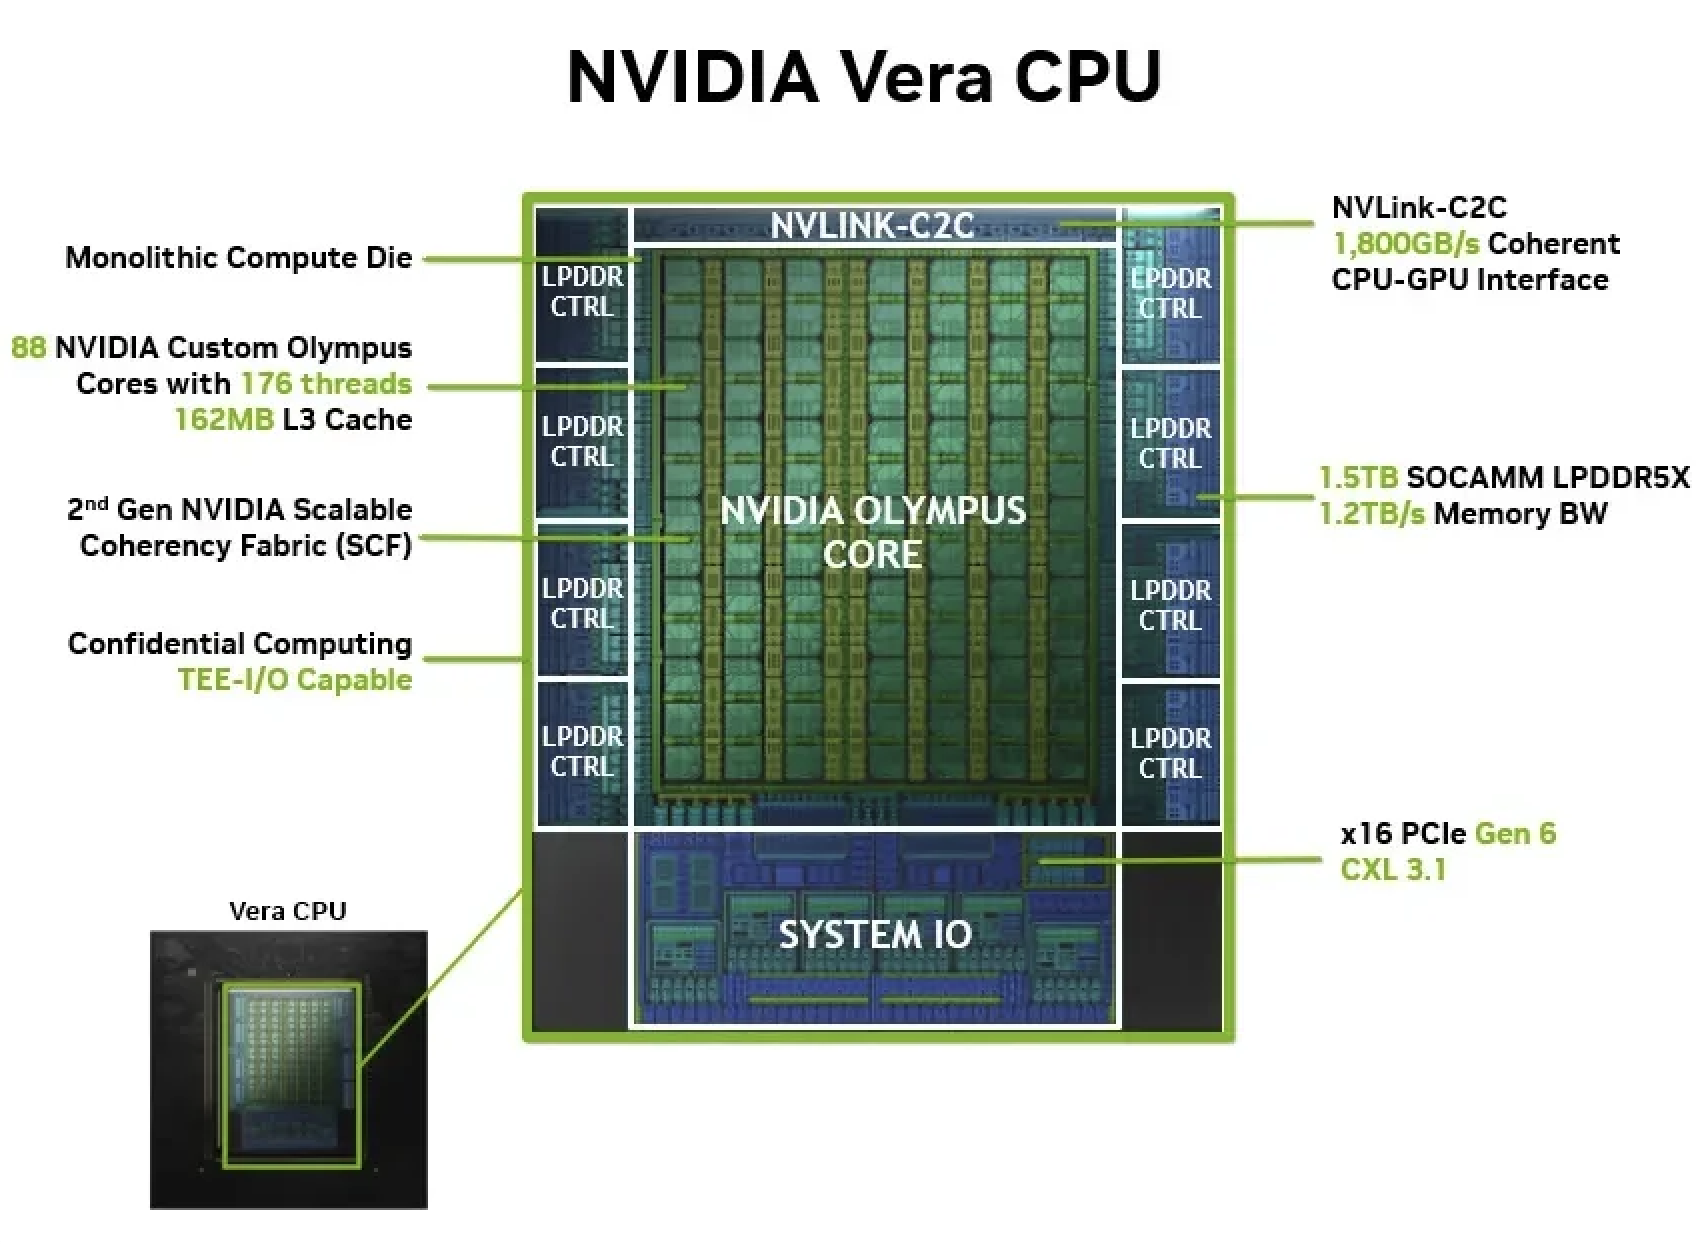
Vera CPU 首度採用 Nvidia 自研的 Olympus 架構,台積電 N3 製程與 CoWoS-R 先進封裝,並首度導入空間多執行緒 (Spatial Multithreading) 技術,核心數/執行緒數為 88/176。儘管核心數/執行緒數較 Intel、AMD 今年推出的旗艦 CPU 少,但身處 Nvidia 生態系的 Vera CPU 可與 Nvidia GPU 進行高達 1.8 TB/s 的 NVLink-C2C 互連,實現和 GPU 的記憶體共享。
圖 3. Nvidia Vera CPU
來源:Nvidia
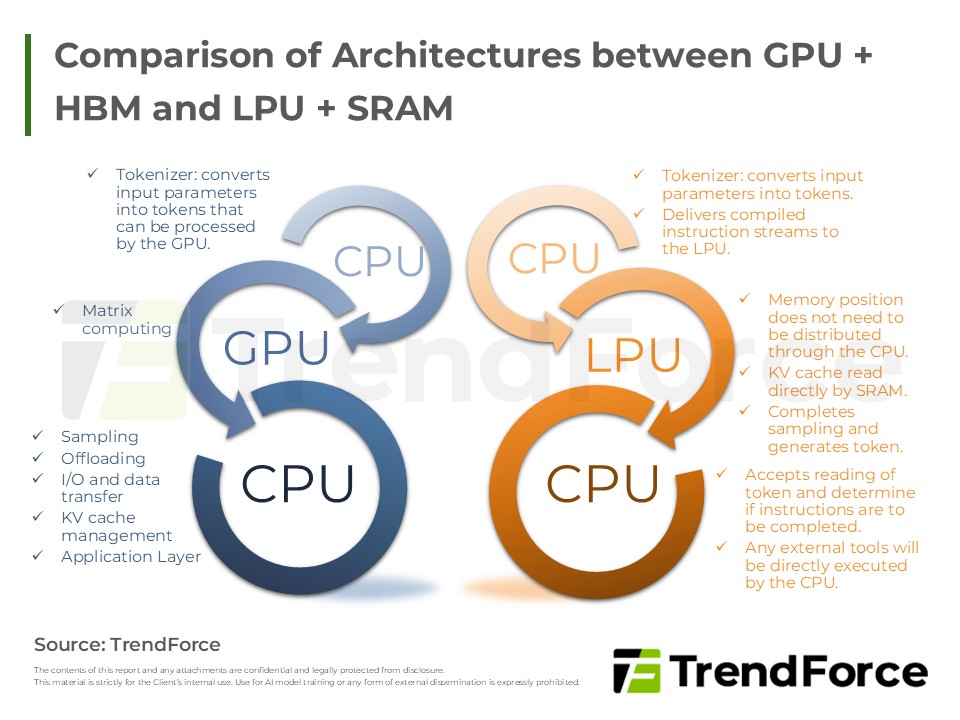
2026-2030 NVIDIA AI 展望:GPU 至 LPU 整機櫃佈局與推理趨勢
NVIDIA 透過整合 GPU、CPU 與 LPU 整機櫃方案,全面擴張 AI 工廠佈局,同時鞏固訓練與推理市場的主導地位。
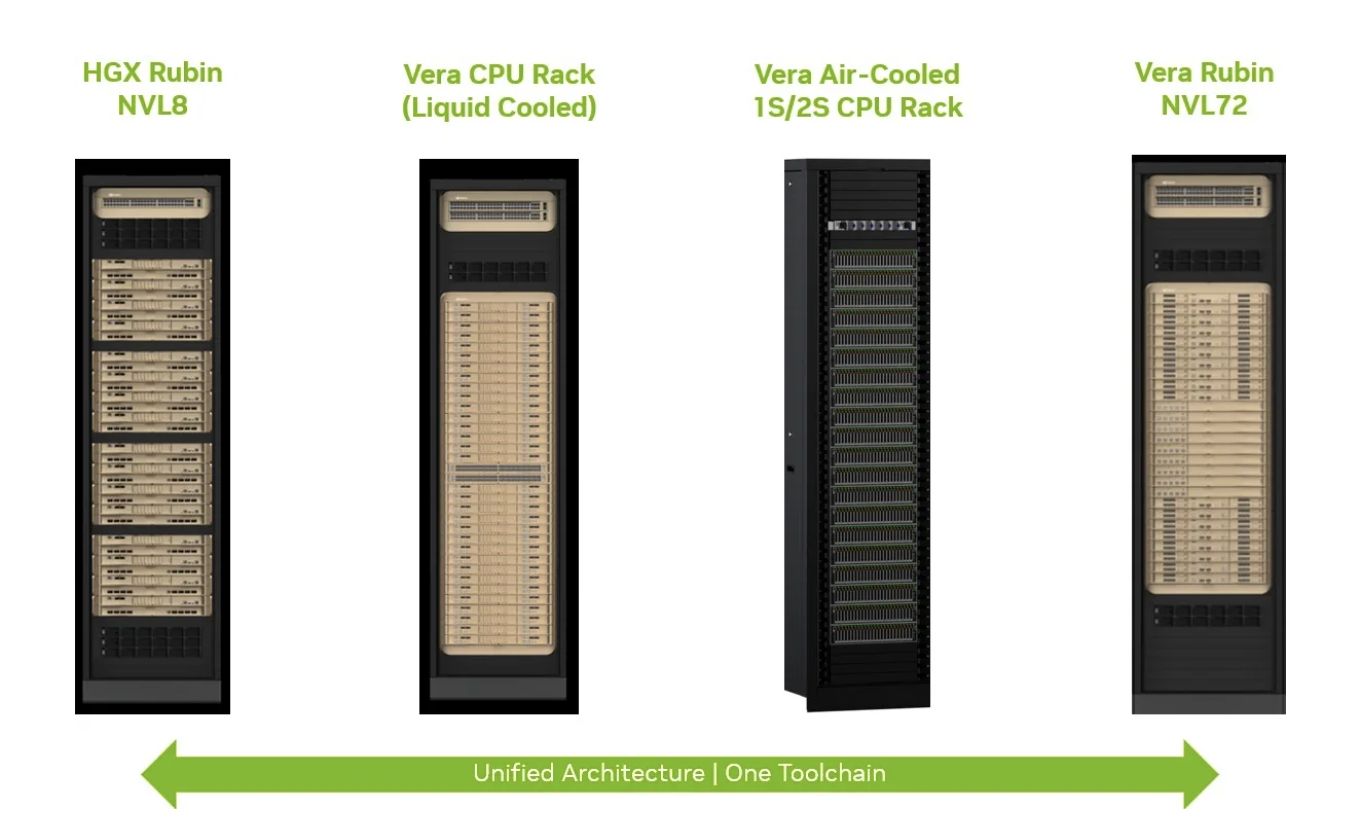
獲取完整報告此外,Nvidia 推出基於 Nvidia MGX 架構的 Vera CPU Rack,單一個 rack 共有 32 個 1U compute tray,一個 compute tray 共有 4 個 Vera CPU Node,共可以整合 256 顆 Vera CPU,整體核心數/執行緒數達 22,528/45,056,記憶體容量達 400 TB,並採用整合 Grace CPU、ConnectX-9 的 BlueField-4 DPU 與其他 Rack 互連,與 Nvidia 生態系高度整合。有關資料中心 scale-out 互連競爭的深入分析,請參閱 InfiniBand vs Ethernet:Broadcom 與 NVIDIA 的 Scale-Out 技術之戰。
圖 4. Nvidia Vera CPU Rack
來源:Nvidia
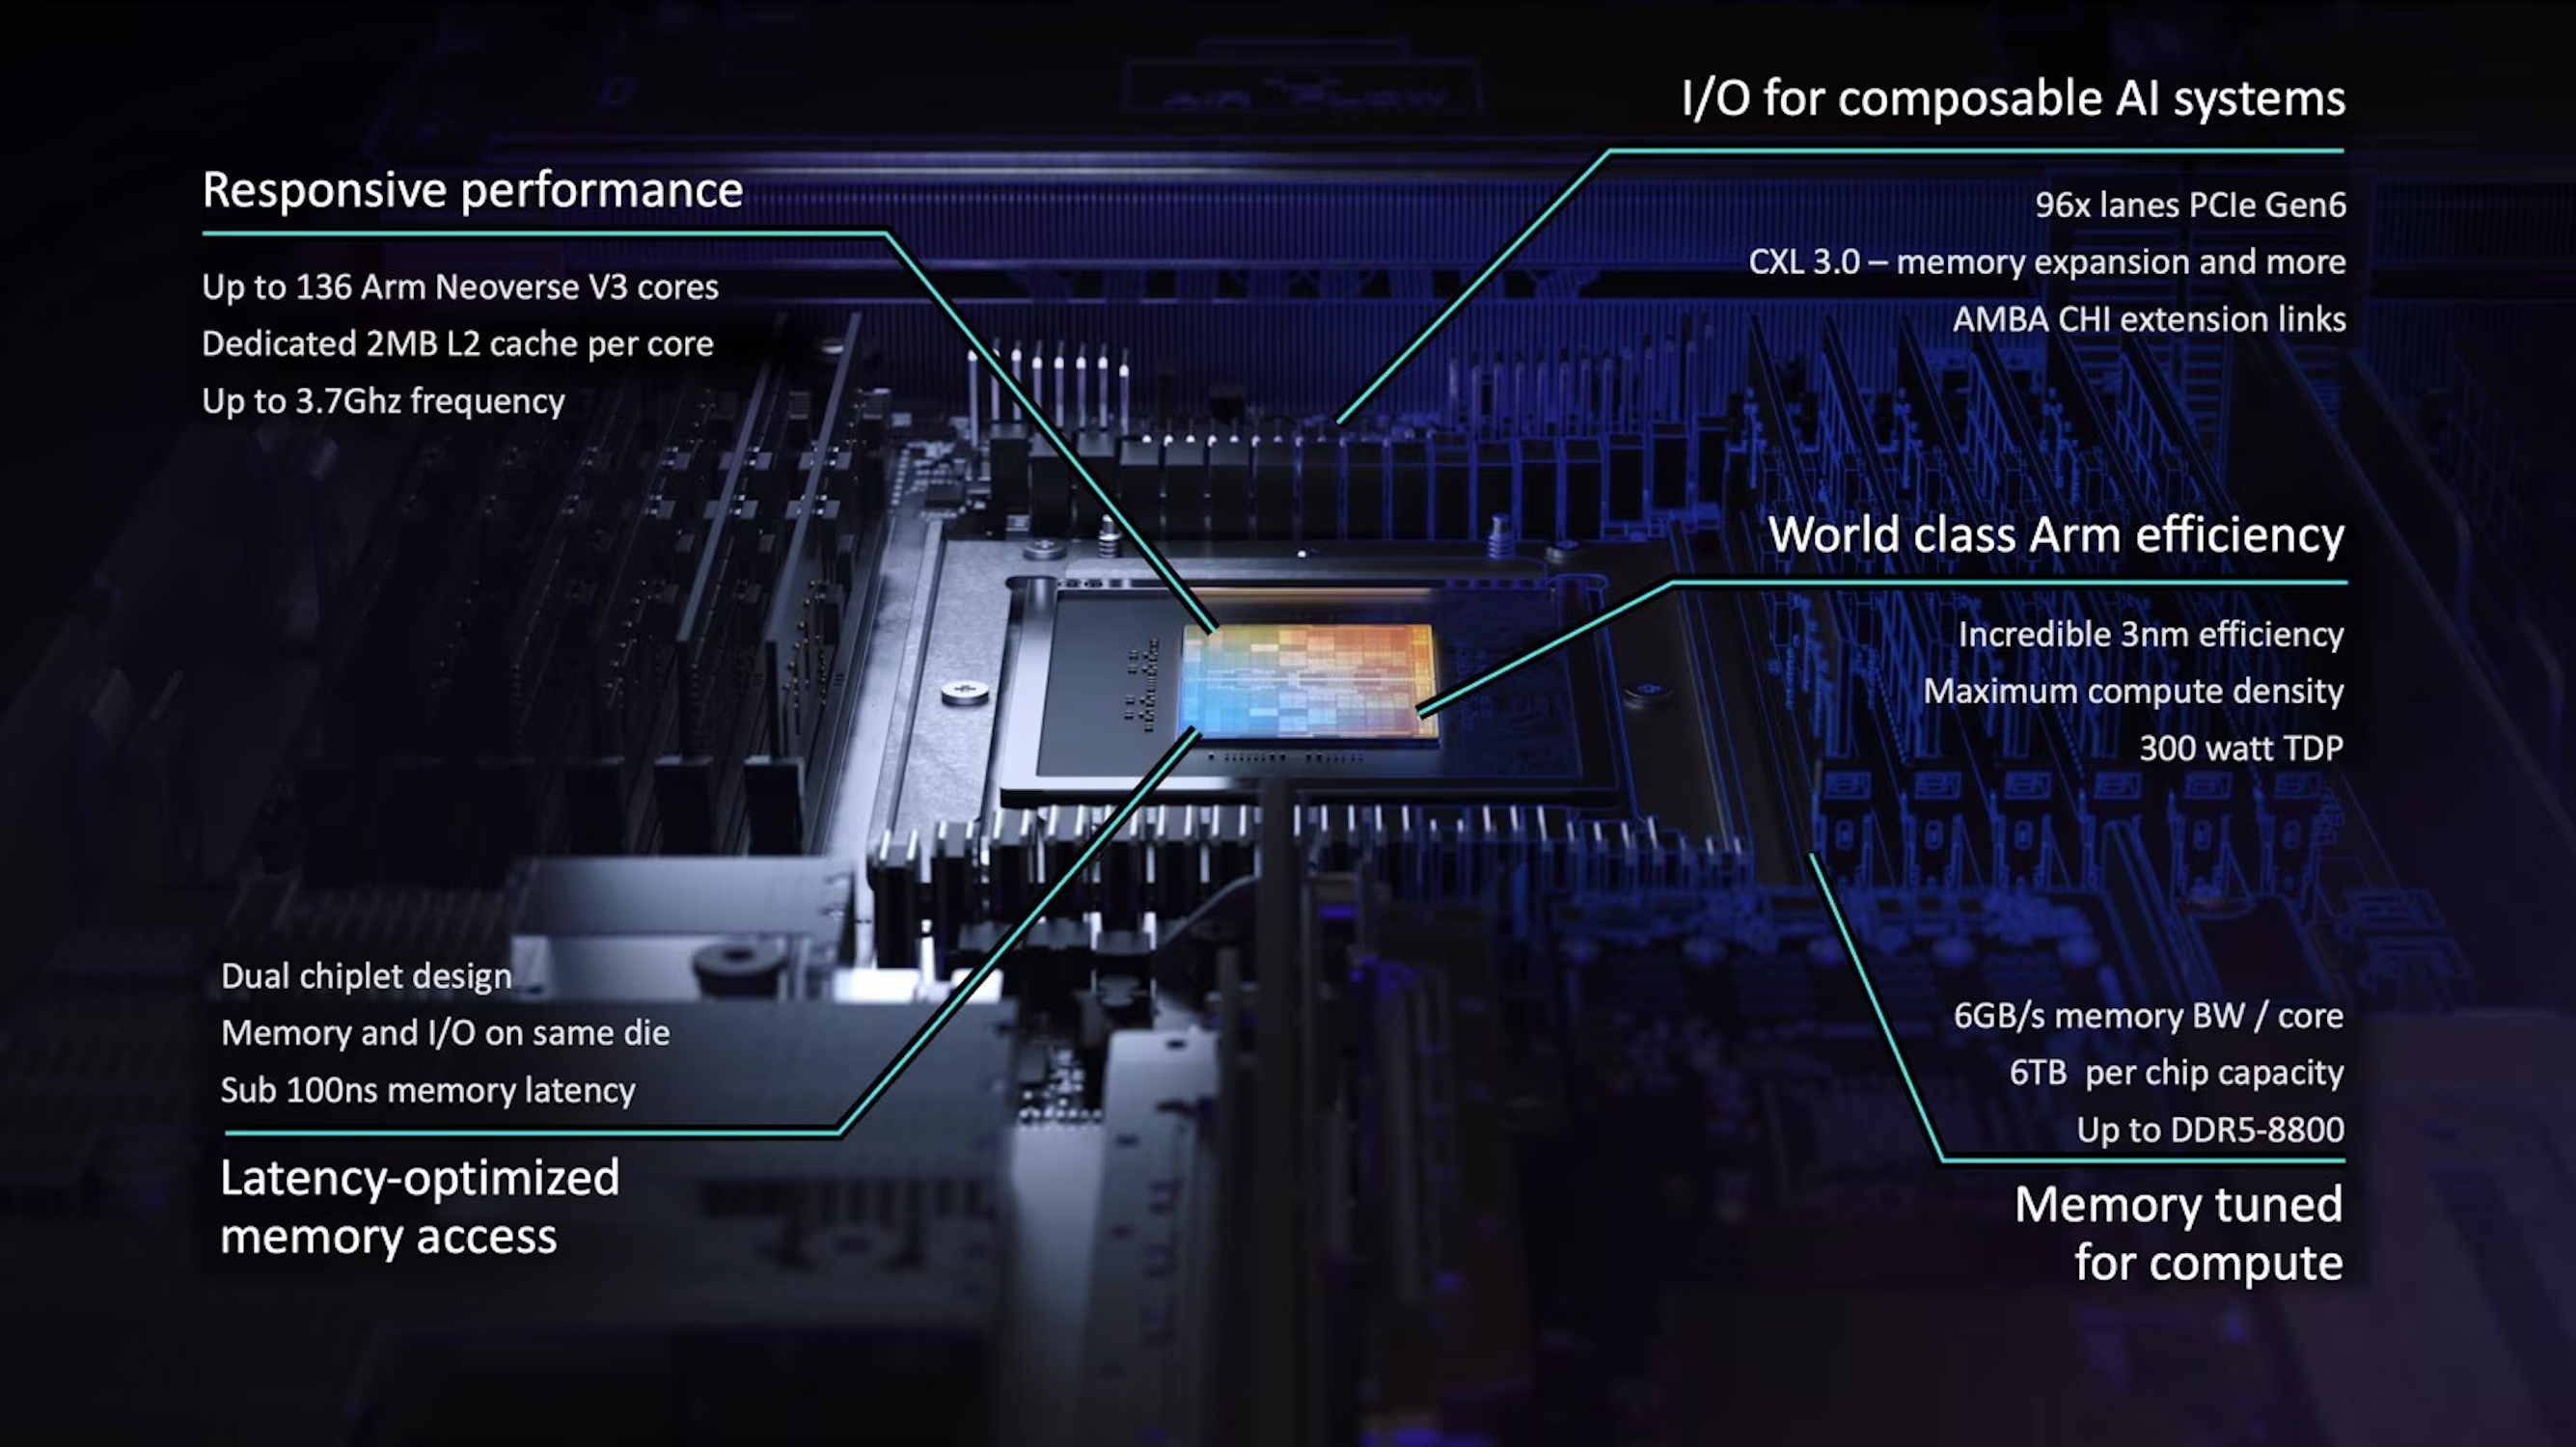
2026 年 3 月 25 日,Arm 架構 IP 大廠 Arm 也不約而同地改變商業模式,推出自研的 CPU 平台 Arm AGI CPU。第一款 Arm AGI CPU 採用台積電 N3 製程,基於 Arm Neoverse V3 架構,核心數/執行緒數為 136/136。Arm AGI CPU 的首批合作夥伴包括 Meta、Cerebras、Cloudflare、F5、OpenAI、Positron、Rebellions、SAP、SK Telecom 等。
圖 5. Arm AGI CPU
來源:Arm
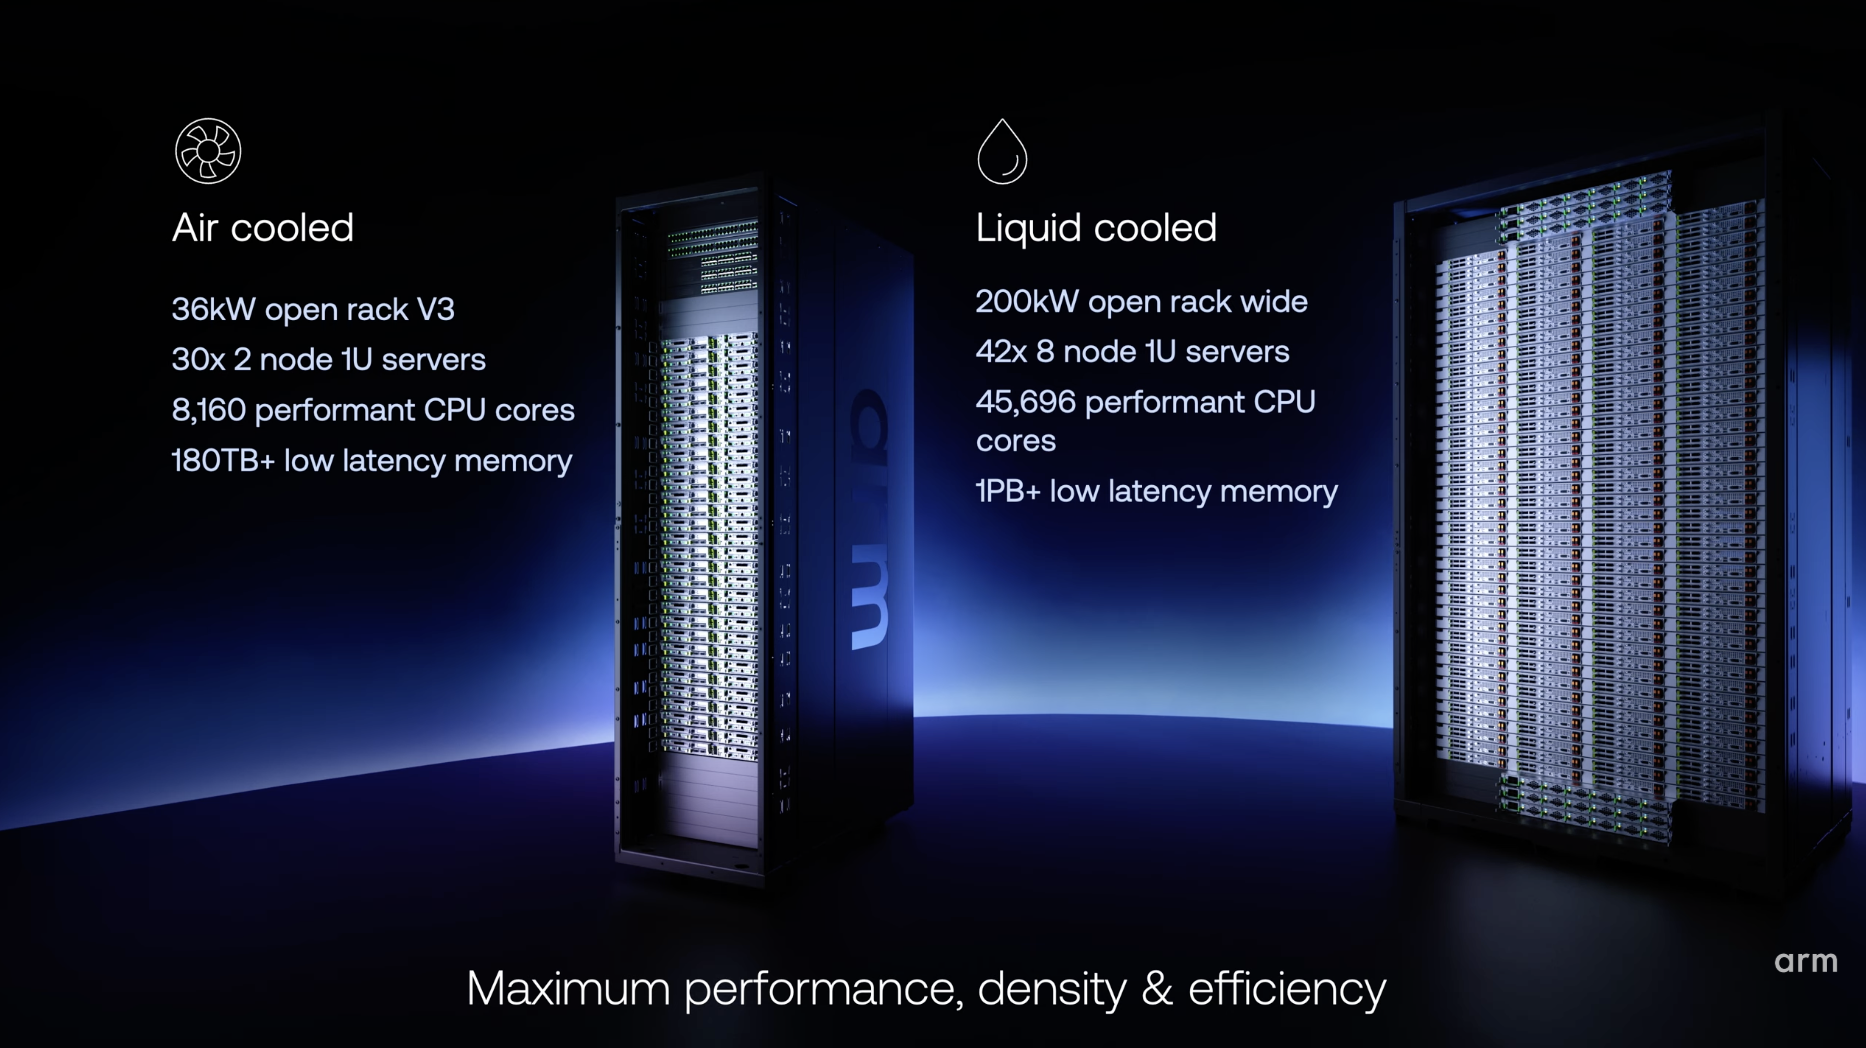
與 Nvidia 相同,Arm 也推出單獨的 CPU Rack,分為氣冷和水冷 2 種版本。氣冷版本的單一個 rack 僅有 30 個 1U compute tray,一個 compute tray 共 2 顆 Arm AGI CPU,共整合 60 顆 Arm AGI CPU,整體核心數/執行緒數僅為 8,160/8,160,記憶體容量僅約 180 TB。水冷版本的單一 rack 則有 42 個 1U compute tray,一個 compute tray 共 8 顆 Arm AGI CPU,可以整合 336 顆 Arm AGI CPU,整體核心數/執行緒數可達 45,696/45,696,記憶體容量高達 1 PB。
圖 6. Arm AGI CPU Rack
來源:Arm
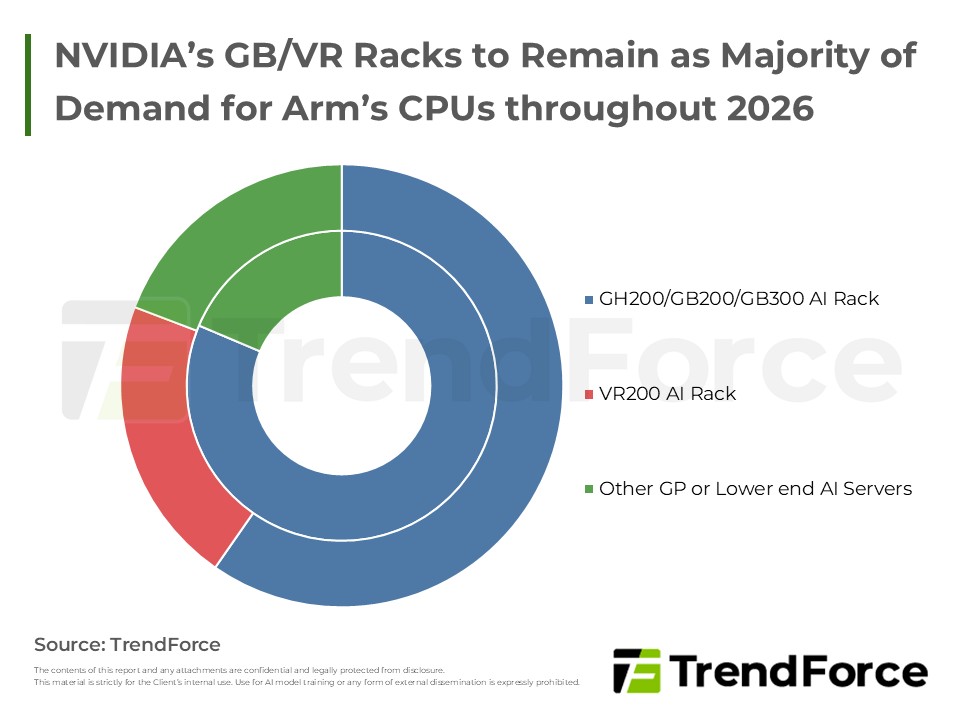
Arm AGI CPU 崛起:AI 資料中心架構重組與市場版圖重劃
Arm AGI CPU 標誌其策略轉型,從 IP 供應商升級為平台參與者,鎖定 AI 資料中心市場,加速搶攻 x86 份額。
洞察轉變SoftBank 旗下的 Arm 架構 CPU 供應商 Ampere,繼 4Q23 推出核心數/執行緒數為 192/192 的 AmpereOne、AmpereOne M 後,預計在 2026 年進一步推出核心數/執行緒數高達 256/256 的 AmpereOne MX。
在美系四大 CSP 中,AWS 最早在 2016 年推出第一款自研 CPU Graviton,採用台積電 N16 製程。2025 年 12 月進一步推出 Graviton5,採用台積電 N3 製程,核心數/執行緒數達 192/192。透過使用自研 CPU 搭配自研 AI ASIC Trainium3,AWS 得以降低 AI 運算的成本。
Microsoft 為第二個推出自研 CPU 的 CSP,於 2023 年 11 月同步發表 AI ASIC Maia 100 和 Cobalt 100 CPU,採用台積電 N5 製程。2025 年 11 月再推下一代的 Cobalt 200,採用台積電 N3 製程,核心數/執行緒數為 132/132。
2024 年 4 月,Google 跟進推出首款自研 CPU Axion C4A,採用台積電 N5 製程。2026 年,Google 進一步推出 Axion C4A 的裸機版 Axion C4A metal,核心數/執行緒數為 96/96,以及下一代的 Axion N4A,核心數/執行緒數為 64/64,旨在打造最高性價比的 CPU。
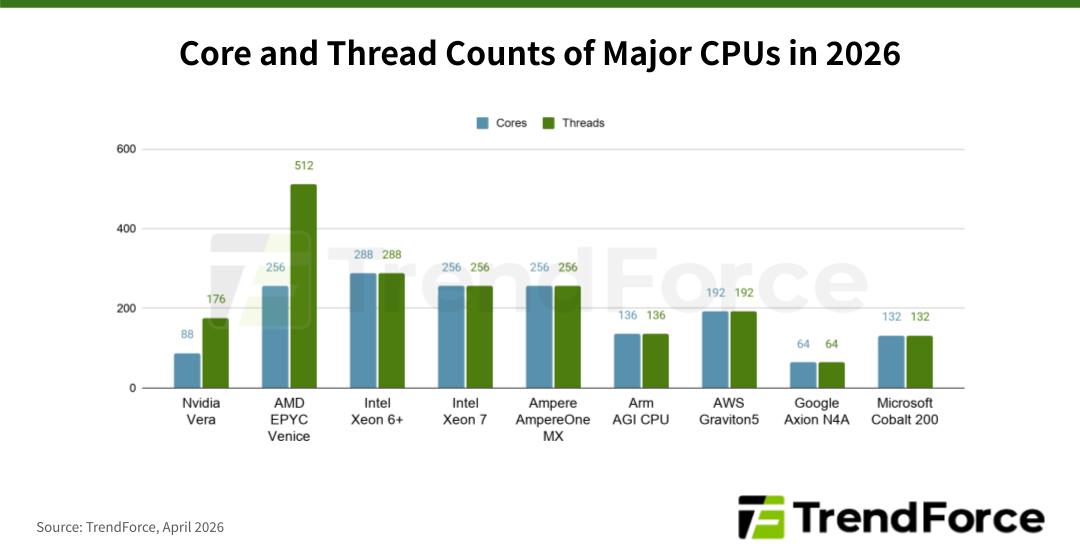
下表彙整 2026 年主要 CPU 的核心數/執行緒數,可以觀察在 2026 年 Intel Xeon 6+ (Clearwater Forest) 將達到最大核心數 288 個,其次為 AMD EPYC Venice、Intel Xeon 7 (Diamond Rapids)、Ampere AmpereOne MX 的 256 個核心。然而,由於採用同步多執行緒 (Simultaneous Multithreading, SMT) 技術,AMD EPYC Venice 可以在 256 個核心中執行 512 個執行緒,將達到目前最大執行緒數。
圖 7. 2026 年主要 CPU 核心數/執行緒數
來源:TrendForce(Unit:個)
各大 CSP 自研 CPU 的趨勢也預計為 IC 後段設計服務商帶來額外商機,如目前除了 AWS 維持 in-house 設計,Google、Microsoft 皆委由創意電子 (GUC) 進行 CPU 後段設計服務。
有關 NVIDIA scale-up 生態系統演進及 ASIC 定位的深入分析,請參閱 ASIC 能否超越 GPU?NVIDIA Scale-Up 技術與未來發展。